通义万相 2.2(Wan 2.2)是阿里云推出的新一代多模态生成模型。该模型采用创新的 MoE(Mixture of Experts)架构,由高噪专家模型和低噪专家模型组成,能够根据去噪时间步进行专家模型划分,从而生成更高质量的视频内容。
Wan 2.2 具备三大核心特性:影视级美学控制,深度融合专业电影工业的美学标准,支持光影、色彩、构图等多维度视觉控制;大规模复杂运动,轻松还原各类复杂运动并强化运动的流畅度和可控性;精准语义遵循,在复杂场景和多对象生成方面表现卓越,更好还原用户的创意意图。 模型支持文生视频、图生视频等多种生成模式,适用于内容创作、艺术创作、教育培训等多种应用场景。
模型依次放入指定ComfyUI目录:
───📂 models/
│ ├───📂 diffusion_models/
│ │ ├─── wan2.2_i2v_low_noise_14B_fp16.safetensors
│ │ └─── wan2.2_i2v_high_noise_14B_fp16.safetensors
│ ├───📂 text_encoders/
│ │ └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors
│ └───📂 vae/
│ └── wan_2.1_vae.safetensors
工作流使用方法: https://docs.comfy.org/zh-CN/tutorials/video/wan/wan2_2
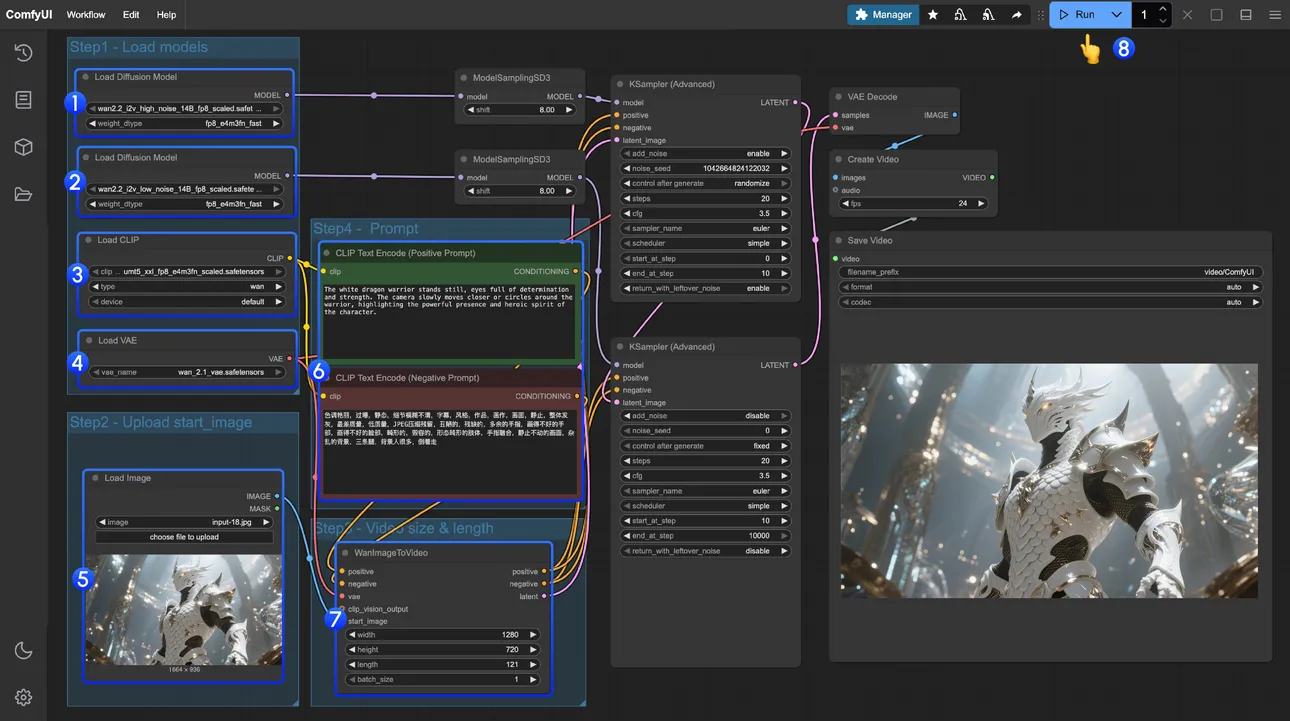
- 确保第一个
Load Diffusion Model节点加载了wan2.2_i2v_high_noise_14B_fp8_scaled.safetensors模型 - 确保第二个
Load Diffusion Model节点加载了wan2.2_i2v_low_noise_14B_fp8_scaled.safetensors模型 - 确保
Load CLIP节点加载了umt5_xxl_fp8_e4m3fn_scaled.safetensors模型 - 确保
Load VAE节点加载了wan_2.1_vae.safetensors模型 - 在
Load Image节点上传作为起始帧的图像 - 如果你需要修改提示词(正向及负向)请在序号
6的CLIP Text Encoder节点中进行修改 - 可选)在
EmptyHunyuanLatentVideo你可以进行尺寸的设置调整,和视频总帧数length调整 - 点击
Run按钮,或者使用快捷键Ctrl(cmd) + Enter(回车)来执行视频生成